모델 설정 및 매개변수
Backend.AI GO는 모델 실행 및 텍스트 생성 방식을 세밀하게 조정할 수 있는 다양한 설정 옵션을 제공합니다. 이 페이지에서는 사용 가능한 모든 설정을 상세히 설명합니다.
실행 매개변수
모델을 실행해 메모리에 올릴 때 적용되는 설정입니다. 하드웨어 사용량과 모델의 기본 성능을 결정합니다.
하드웨어 가속
- GPU 레이어: 모델의 몇 개의 레이어를 GPU로 오프로드할지 결정합니다.
- -1 (기본값): llama.cpp가 정합니다. 모델이 GPU 메모리에 들어가면 모든 레이어를 오프로드하고, 들어가지 않으면 나머지를 CPU에 둡니다.
- 숫자: 지정한 수만큼 레이어를 오프로드하고, 나머지는 CPU에서 실행합니다. 숫자를 지정하면 llama.cpp의 자동 배치를 사용하지 않습니다.
- 0: 전체를 CPU에서 실행합니다 (느림).
- CPU로 보낼 전문가 레이어 (MoE 모델 전용, llama.cpp 전용): 앞쪽 N개 레이어의 전문가 가중치를 시스템 메모리에 둡니다(
--n-cpu-moe). 전문가 가중치가 GPU 메모리에 다 들어가지 않는 MoE 모델도 나머지 가중치는 GPU에서 실행하므로, 레이어 전체를 CPU에 두는 것보다 대개 빠릅니다. 모델 파일에 전문가 정보가 있으면 이 항목이 나타납니다. 0(기본값)이면 사용하지 않습니다. 0이 아닌 값을 지정하면 llama.cpp의 자동 배치를 사용하지 않으므로, GPU 레이어 설정이 허용하는 레이어는 모두 GPU로 갑니다. 설정 > 성능에서 GPU 메모리에 들어가지 않는 MoE 모델의 값을 찾을 수 있고,aigo loaded show와 실행 관리의 실행 정보는 실행 중인 모델이 시작할 때 사용한 값을 보여 줍니다. 메모리 예상치는 해당 전문가 가중치를 GPU 메모리가 아닌 시스템 메모리로 계산하므로, 호환성 검사와 자동 컨텍스트 제한도 이 가중치를 GPU 몫으로 치지 않습니다. 모델 파일에 전문가 정보가 없는 모델에는 값을 저장할 수 없고, 이전에 저장된 값은 모델을 실행할 때 무시됩니다. - 메인 GPU: GPU가 여러 개인 경우, 주 연산 장치로 사용할 GPU를 선택합니다.
- 분할 모드: 다중 GPU 환경에서 모델을 여러 장치에 어떻게 분배할지 결정합니다 (예: Row Split, Layer Split).
메모리 및 컨텍스트
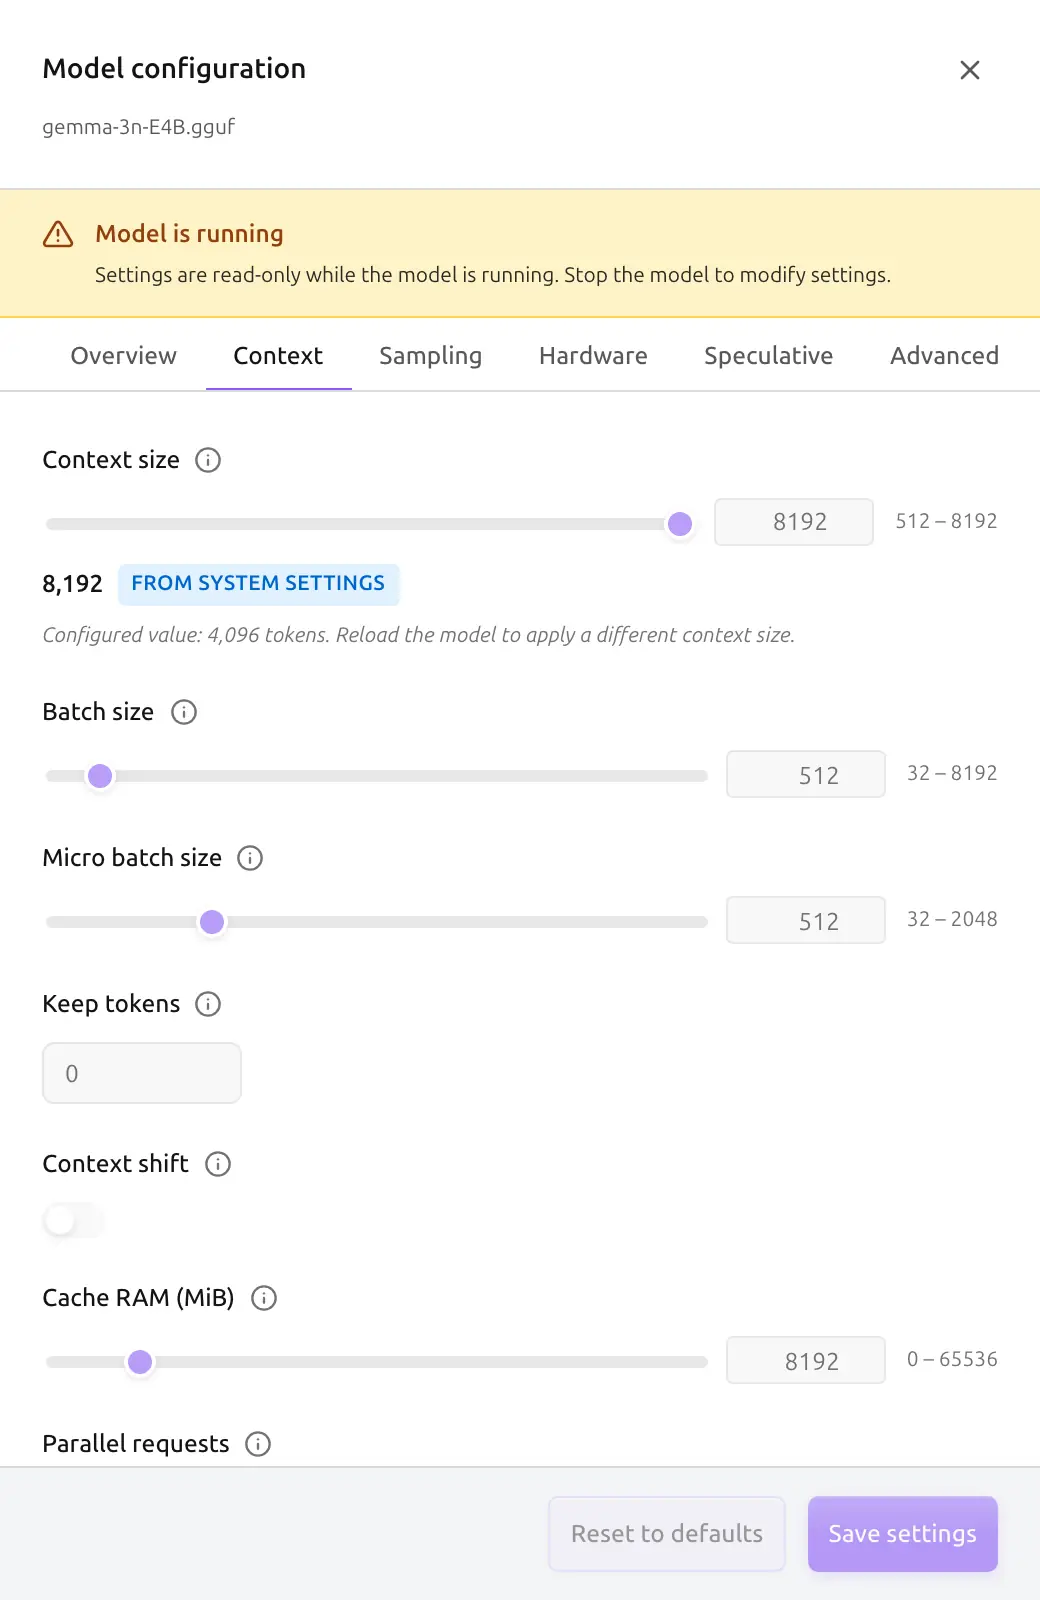
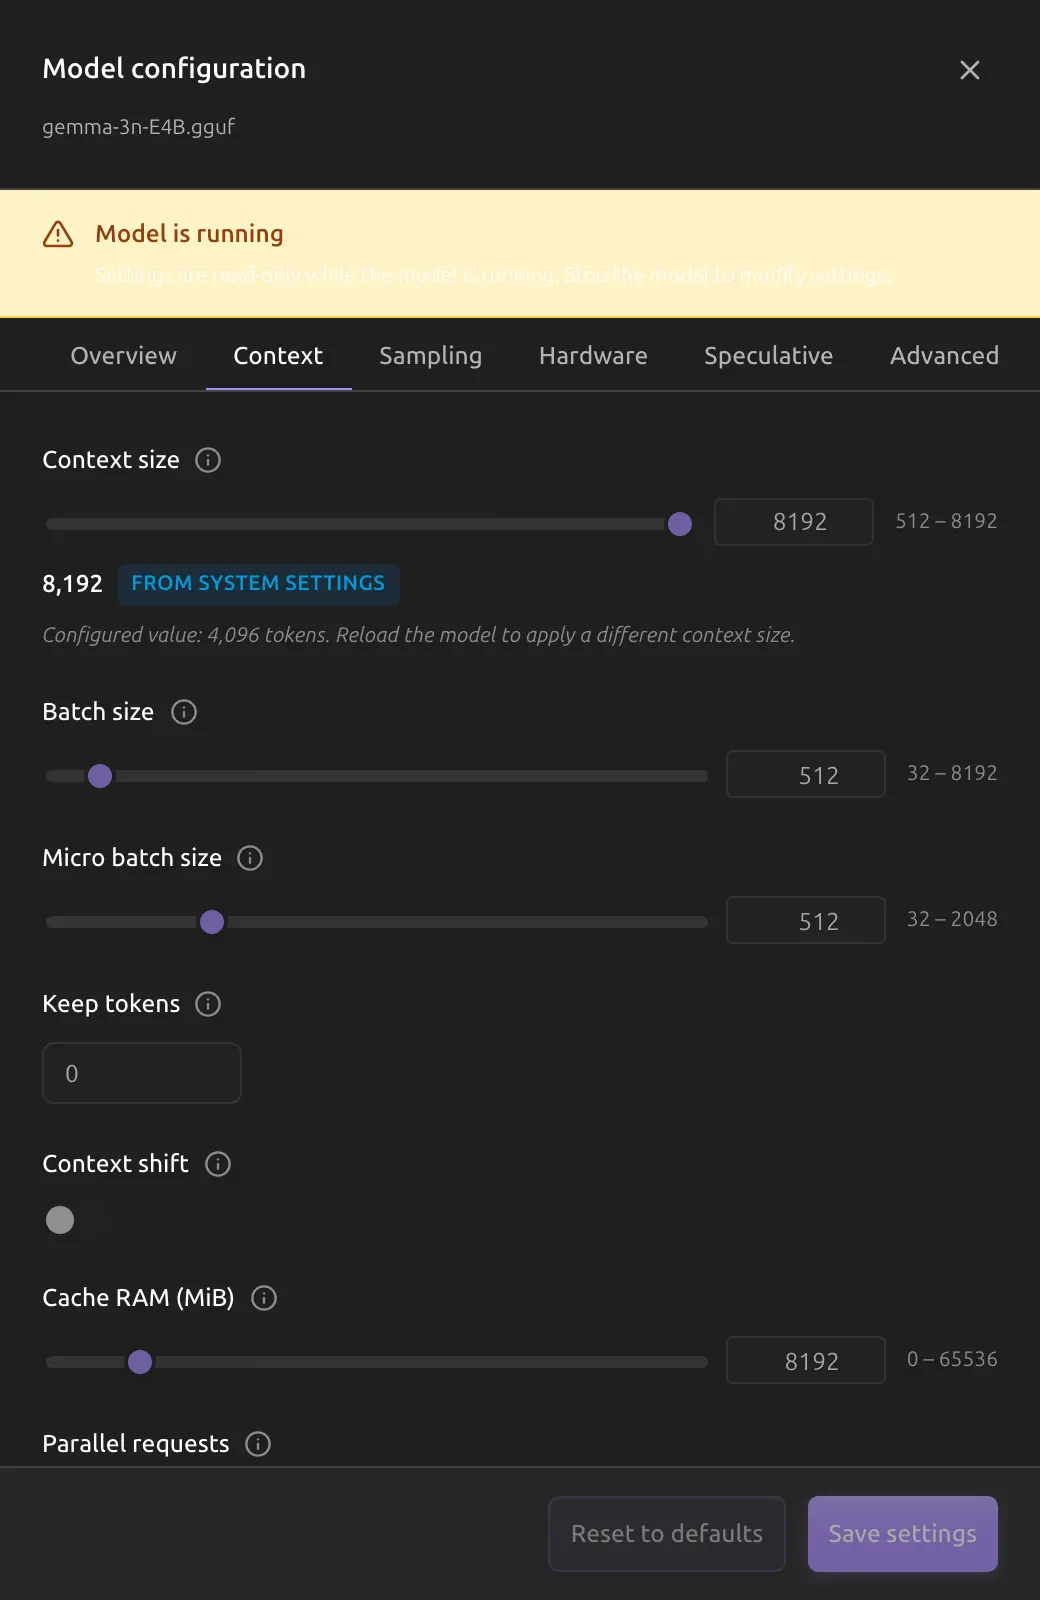
- 컨텍스트 길이: 모델이 한 번의 요청에서 받아들이는 최대 토큰 수입니다. 전달되는 대화 내용과 생성 결과가 이 안에 함께 들어갑니다.
- 참고: 컨텍스트가 길수록 더 많은 VRAM/RAM을 사용합니다.
- 기본값: 모델에 따라 보통 2048 또는 4096입니다.
- 배치 크기: 프롬프트 평가 시 병렬로 처리할 토큰 수입니다. 값이 높으면 긴 프롬프트 처리 속도가 빨라지지만 VRAM 사용량이 늘어납니다.
- 병렬 요청: 실행 중인 모델이 동시에 처리하는 요청 수입니다 (1~8, 기본값 2). 각 요청은 컨텍스트 길이 전체를 사용할 수 있습니다. 동시에 실행되는 요청들은 이를 공유하므로 합쳐서 컨텍스트 길이를 넘을 수 없으며, llama.cpp에서는 넘치는 순간 진행 중인 요청들이
Context size has been exceeded.오류로 실패합니다. MLX 모델은 엔진이 공유 컨텍스트를 지원할 때까지 현재 한 번에 하나의 요청만 처리합니다. 자세한 조정 방법은 병렬 요청 슬롯을 참고하세요. - Flash Attention: 메모리 효율적인 어텐션 메커니즘을 활성화합니다 (호환되는 하드웨어 필요).
- RoPE 스케일링 (고급 탭): 학습한 컨텍스트 길이보다 긴 입력을 처리하도록 모델의 위치 인코딩을 확장하는 방식입니다.
- 모델 기본값: 모델 파일에 지정된 스케일링이 사용되므로, gpt-oss에는 YaRN 스케일링이 그대로 적용됩니다.
- 끄기: 모델의 스케일링이 사용되지 않습니다(
--rope-scaling none). - 선형, YaRN: 아래에 나타나는 RoPE 스케일과 RoPE 주파수 베이스 값으로 해당 방식을 적용합니다(
--rope-scaling linear또는--rope-scaling yarn). YaRN을 선택하면 YaRN 원본 컨텍스트도 지정할 수 있습니다. 각 값은 해당 방식을 선택한 경우에만 적용되며, 모델 기본값이나 끄기로 돌아가면 이전에 입력한 값은 전달되지 않습니다. - RoPE 스케일링은 llama.cpp 모델에만 적용되고, MLX 모델에는 모델 자체의 스케일링이 사용됩니다.
성능
- 스레드: 추론에 사용할 CPU 스레드 수입니다 (GPU로 완전히 오프로드되지 않았을 때 중요).
- NUMA 지원: 다중 소켓 CPU 시스템을 위한 최적화 옵션입니다.
추측 디코딩 (Speculative Decoding)
추측 디코딩은 작고 저렴한 드래프터 모델을 실행하여 단계마다 여러 토큰을 제안하고, 메인 모델이 한 번의 추론으로 이를 검증한 뒤 올바른 접두사 중 가장 긴 부분을 채택하는 기법입니다. temperature 0에서는 출력이 일반 디코딩과 바이트 단위로 동일하므로, 호환되는 드래프터가 있을 때 순수한 지연 시간 이득이 됩니다. 모델별로 모델 설정 드로어의 추측 디코딩 탭에서 구성합니다. 일부 GGUF 변환본은 메인 파일 안에 MTP 예측 가중치를 담고 있어서 별도의 드래프터가 아예 필요 없습니다(아래 가속 모드 참고).
두 내장 엔진 모두 드래프트 모델 경로를 지원하지만 내부 플래그가 다릅니다 — 앱이 대상 모델 형식에 따라 올바른 플래그를 자동으로 선택합니다.
- 추측 디코딩 사용: 마스터 스위치입니다. 꺼져 있으면(기본값) 모델에 아무 변화가 없습니다.
- 가속 모드 (GGUF 대상 전용): 초안 토큰을 어디서 얻을지 결정합니다.
- 외부 드래프터(기본값)는 아래에서 설명하는 기존 방식이며 별도의 드래프터 체크포인트가 필요합니다.
- 내장 MTP는 메인 GGUF 안에 이미 들어 있는 next-n MTP 가중치를 사용하므로 다운로드할 것도, 선택할 드래프터도 없습니다. llama-server가 모델 자체를 대상으로 초안 컨텍스트를 만듭니다. Qwen 3.5와 GLM MoE 계열 변환본이 이 가중치를 담고 있지만 배포자가 유지한 경우에만 그렇기 때문에, 앱은 파일 이름이 아니라 메타데이터를 읽어 판단합니다. 해당 파일에 MTP 가중치가 없더라도 llama-server는 그대로 시작해서 평범한 속도로 디코딩하며, 앱이 그 사실을 경고로 기록합니다.
- 내장 MTP를 선택하면 드래프터 선택기, 초안 GPU 레이어, 드래프터 알고리즘이 숨겨집니다. 초안 모델이 없으면 어느 것도 적용되지 않기 때문입니다. 이전에 설정해 둔 드래프터는 저장된 채로 남지만 이 모드에서는 무시됩니다.
- n-gram은 대화에 이미 나온 텍스트에서 초안 토큰을 찾기 때문에(
--spec-type ngram-mod) 드래프터가 전혀 필요 없습니다. 붙여 넣은 글을 고쳐 다시 쓰는 경우처럼 모델이 이미 본 긴 문장을 다시 쓰는 답변만 빨라지고, 나머지 답변은 일반 속도로 디코딩합니다. 선택하면 드래프터 선택기와 초안 모델 설정(최대·최소 초안 토큰, 최소 채택 확률, 초안 GPU 레이어, 드래프터 알고리즘, 엔진 기본 추측 설정)이 모두 숨겨집니다. 드래프터가 없으면 대화용 설정 맞추기가 이 모드를 측정해 보고 더 빠를 때만 유지합니다. - MLX 대상에는 이 항목이 표시되지 않습니다. mlxcel은 별도로 추출한 드래프터 체크포인트에서만 MTP를 실행하고 메인 체크포인트의 내장 next-n 레이어를 버리며, 드래프터 없는 추측도 지원하지 않으므로, 드래프터 없는 MLX 실행은 엔진이 시작되기 전에 거부됩니다.
- 드래프터 모델: 초안 토큰을 제안하는 작은 모델입니다. 대상과 같은 형식으로 다운로드된 로컬 모델을 선택하거나(GGUF 대상에는 GGUF 드래프터, MLX 대상에는 MLX 드래프터), 직접 입력을 선택해 로컬 경로 또는 Hugging Face 저장소 ID를 입력하세요.
- llama.cpp (GGUF) 대상의 경우 Hugging Face 저장소 ID(
org/repo[:quant])는 자동 다운로드되며, 로컬 경로는 그대로 사용됩니다. - MLX (mlxcel) 대상의 경우 드래프터는 로컬 디렉토리여야 합니다. 이 버전에서는 MLX용 Hugging Face 저장소 ID가 자동 다운로드되지 않으므로, 먼저 드래프터를 다운로드한 다음 해당 폴더를 참조하세요.
- llama.cpp (GGUF) 대상의 경우 Hugging Face 저장소 ID(
- 최대 초안 토큰: 드래프터가 단계마다 제안하는 토큰 수입니다. 두 엔진 모두 기본값은 16입니다.
llama.cpp 전용 항목 (GGUF 대상에 표시): 최소 초안 토큰, 최소 채택 확률, 초안 GPU 레이어, 그리고 드래프터 알고리즘 관련 세 가지 항목.
- 드래프터 알고리즘: llama-server가 실행할 추측 알고리즘입니다. 자동(기본값)은 플래그를 보내지 않으므로 번들 엔진이 초안 모델의 메타데이터에서 드래프터 종류를 감지합니다. 이 감지 기능이 없는 것은 b10415보다 오래된 엔진뿐입니다. MTP를 선택하면
draft-mtp를 명시적으로 강제합니다. 이는 llama.cpp 자체의 선택 항목이며, 아래 mlxcel 드래프터 종류 설정과는 무관합니다. - 엔진 기본 추측 설정 사용: 여기서 설정한 값 위에 llama-server의 내장 기본 추측 설정을 적용합니다. 드래프터 알고리즘을 명시적으로 선택한 경우에만 적용됩니다. 자동으로 두면 llama-server의 기본 추측 설정이 드래프터 자동 감지를 대체하여 ngram 전용 추측만 실행되므로, 명시적인 알고리즘을 선택하기 전까지 앱이 이 토글을 비활성화합니다.
- 추론 블록 보존: 이전 어시스턴트 턴의 추론 블록을 제거하지 않고 유지합니다. 모델의 채팅 템플릿이 이를 지원할 때만 적용되며, 지원하지 않는 템플릿에서는 llama-server가 경고를 기록하고 무시합니다.
mlxcel 전용 항목 (MLX 대상에 표시):
- 드래프터 종류: mlxcel이 드래프터 체크포인트를 해석하는 방식입니다. 자동(권장)은 체크포인트에서 종류를 감지합니다. 두 종류는 특정 대상 계열에 매핑됩니다.
- MTP(Multi-Token Prediction)는 Gemma 4 대상에 검증되어 있습니다.
- DFlash는 Qwen 3.5 텍스트/VLM 대상에 검증되어 있습니다.
- 초안 블록 크기: 초안 블록 크기(토큰, MTP는 기본 4, DFlash는 기본 16).
대상이 Gemma 4 또는 Qwen 3.5 모델로 보이면 앱이 비차단 힌트를 표시하지만, 짝을 하드 차단하지는 않습니다 — 엔진이 소스 오브 트루스이며 드래프터가 호환되지 않으면 일반 디코딩으로 대체됩니다. 드래프터를 해석할 수 없으면(존재하지 않는 로컬 경로) 엔진이 시작되기 전에 명확한 오류와 함께 실행이 실패합니다.
엔진 수준의 세부 사항은 llama.cpp 가속과 Apple MLX 가속을 참고하세요.
vLLM 설정
다운로드한 Hugging Face safetensors 저장소는 컨테이너 엔진에서 실행되는데, 이런 모델의 설정 창에는 모델 카드가 요구하는 vllm serve 플래그를 지정하는 vLLM 탭이 있습니다. 도구 호출 파서와 추론 파서, GPU 메모리 비율, 텐서 병렬 크기, MoE 백엔드, KV 캐시 타입, 프리픽스 캐싱, 하이브리드 모델의 Mamba 설정, 초안 모델을 사용하는 추측 디코딩을 여기서 정하고, 설정하지 않은 항목은 플래그를 추가하지 않습니다. 추측 디코딩 탭은 llama.cpp와 MLX 모델에 적용되므로 이런 모델의 추측 디코딩도 이 탭에서 설정해야 하죠. 설정마다 대응하는 플래그와 실제 예시는 모델별 실행 설정을 참고하세요.
생성 매개변수
채팅 중 "대화 매개변수" 서랍에서 볼 수 있는 이 설정들은 모델 답변의 창의성과 행동을 제어합니다.
창의성 및 무작위성
- 온도: 출력의 무작위성을 제어합니다.
- 낮음 (0.1 - 0.5): 집중적, 결정론적, 논리적. 코딩이나 사실적 작업에 적합.
- 높음 (0.8 - 1.5): 창의적, 예측 불가능. 스토리텔링에 적합.
- Top P (Nucleus Sampling): 확률이 높은 상위 토큰들의 집합 내에서만 다음 토큰을 선택하도록 제한합니다.
- Top K: 확률이 가장 높은 K개의 토큰 중에서만 선택하도록 제한합니다.
- Min P: 가장 확률이 높은 토큰 대비 최소 확률 임계값을 설정합니다.
반복 제어
- 반복 페널티: 이미 등장한 단어에 페널티를 부여하여 텍스트가 루프에 빠지는 것을 방지합니다.
- 존재 페널티: 토큰이 텍스트에 한 번이라도 등장했는지 여부에 따라 페널티를 줍니다.
- 빈도 페널티: 토큰이 등장한 횟수에 비례하여 페널티를 줍니다.
구조 제어
- 시스템 프롬프트: 모델의 페르소나와 제약 조건을 정의하는 상위 지침입니다 (예: "당신은 유능한 코딩 조수입니다").
- 중단 문자열: 모델이 생성을 즉시 멈추게 할 특정 텍스트 시퀀스입니다.
- 최대 토큰: 모델이 한 번의 응답에서 생성할 수 있는 최대 토큰 수 제한입니다.
추론 노력
확장 사고(추론 모델)를 지원하는 모델의 경우, 추론 깊이를 제어할 수 있습니다:
-
기본 추론 노력: 설정 > 생성에서 구성합니다. 옵션:
- 없음 (꺼짐): 확장 사고 없음
- 낮음 / 중간 / 높음 / 매우 높음: 점진적으로 깊은 추론
- 마지막 사용 값: 가장 최근에 사용한 설정을 저장해 다시 적용
-
대화별 재정의: 채팅 인터페이스에서 개별 대화의 추론 노력을 직접 조정할 수 있습니다.
Thinking 예산 (수치 상한)
추론 노력 선택값은 모든 채팅 요청에서 thinking_budget_tokens 수치값으로 함께 전송되는데, llama.cpp나 mlxcel-server, vLLM처럼 <think> 토큰 수에 하드 캡을 적용하는 엔진들은 이 값을 그대로 사용합니다.
| 추론 노력 | thinking_budget_tokens |
|---|---|
none (꺼짐) | 0 (즉시 종료) |
| 낮음 | 128 |
| 중간 | 512 |
| 높음 | 2048 |
| 매우 높음 | 8192 |
| (선택 안 함) | 필드 생략, 엔진 기본값(무제한) 적용 |
엔진 의미: -1은 무제한, 0은 즉시 종료(thinking 비활성화), N>0은 엔진이 </think>를 강제로 닫기 전까지 <think> 안에서 출력할 수 있는 토큰 수의 하드 캡입니다. 카테고리 매핑을 직접 지정하고 싶으면 CLI로 aigo chat --thinking-budget <N>를 사용할 수 있습니다(CLI 레퍼런스 참조).
턴 간 thinking 보존 (Qwen3.6+)
모델 설정 드로어의 고급 탭에는 이전 턴 thinking 보존 토글이 있는데, Qwen3.6+ 모델에서만 표시됩니다. 켜면 해당 모델로 시작한 모든 채팅 요청에 chat_template_kwargs.preserve_thinking=true가 들어가서 이전 어시스턴트 턴들의 <think> 블록이 제거되지 않고 그대로 유지됩니다. 멀티턴 도구 사용 시나리오에서 에이전트의 의사결정 일관성이 좋아지고, KV 캐시 프리픽스 재사용도 더 잘 됩니다.
토글은 모델별로 저장되고 기본값은 꺼짐입니다. 그 이전 Qwen3/3.5 모델들도 플래그를 받기는 하지만 동작이 검증되지 않았기 때문에 허용목록으로 게이트를 걸어두었습니다.
대화 매개변수 드로어(대화별로 열림)에도 세 가지 상태를 갖는 이전 턴 thinking 보존 선택기가 있습니다.
- 모델 설정 따르기 (기본값): 대화별 재정의 없음, 위의 모델 수준 설정을 사용합니다.
- 켜기: 모델 기본값이 꺼져 있어도 이 대화의 모든 요청에
preserve_thinking=true를 강제로 적용합니다. - 끄기: 모델 기본값이 켜져 있어도 이 대화의 모든 요청에서 해당 kwarg를 제거합니다.
대화별 재정의가 모델 기본값보다 우선합니다. 모델 설정 따르기로 되돌리면 모델 수준 설정이 다시 적용됩니다.
기본 모델 (Default Models)
설정 > 모델에서 각 인터페이스의 기본 모델을 구성합니다. 이를 통해 각 인터페이스를 열 때 선호하는 모델이 자동으로 선택됩니다.
모델 비교 결과의 기본 모델로 사용도 같은 설정을 바꿉니다. 대화나 긴 문서 비교는 채팅 기본 모델을 바꾸므로 새 대화가 해당 모델로 시작하고, 에이전트 비교는 에이전트 기본 모델을 바꿉니다.
사용 가능한 설정
- 채팅 기본 모델: 새 대화를 시작할 때 사용할 모델입니다. 바꾸면 이후 새 대화부터 적용됩니다. 다음에 여는 새 대화(홈이나 대시보드의 채팅 입력창)의 모델 선택기에는 해당 모델이 실행 중이면 바로 선택되고, 이미 열려 있는 대화는 지금 모델을 그대로 사용합니다. 그 뒤 대화에서 다른 모델을 고르면 다시 기본 모델을 설정하기 전까지는 고른 모델로 새 대화가 시작됩니다. 시작 모델 정책이 마지막 사용 모델 복원(기본값)이면, 실행 중이 아닌 로컬 모델은 다음에 앱을 시작할 때 실행됩니다.
- 이미지 기본 모델: 채팅에서 이미지를 요청하면
generate_image도구가 그림을 그릴 때 사용하는 모델입니다. 로컬 디퓨전 모델이 실행 중이 아니면 먼저 실행됩니다. - 에이전트 기본 모델: 프로필에 모델이 지정되지 않은 에이전트 실행과, 모델을 따로 정하지 않은 스쿼드 에이전트가 사용하는 모델입니다. 실행 중이 아닌 로컬 모델은 실행이 시작될 때 실행됩니다.
- 유틸리티 모델: 제목과, 앱이 스스로 쓰는 짧은 요약(생각 요약, 스쿼드 진행 문구)에 사용됩니다. 없음으로 두면 현재 채팅 모델을 사용합니다.
- 번역 모델: 지금은 이 설정을 읽는 기능이 없고, 채팅에서 번역할 때는 채팅 모델을 사용합니다.
- 추출 모델과 제목 생성 모델: 자동 메모리 추출과 대화 제목에 사용됩니다. 권장 경량 모델(자동)로 두면 권장 소형 모델이 실행 중일 때 해당 모델을 사용하고, 실행 중이 아니면 다음 제목을 위해 실행됩니다.
- 위키 생성 모델과 데이터 요약 모델: 데이터 위키 문서와 문서 카드 요약을 작성할 때 사용됩니다. 없음으로 두면 자동으로 고르는데, 로컬에서 실행 중인 모델이 있으면 해당 모델을, 없으면 설정해 둔 프로바이더를 사용합니다.
모델 선택
다음 중에서 선택할 수 있습니다:
- 로컬 모델: 컴퓨터에 다운로드한 GGUF 모델 ("로컬" 접두사로 표시). 실행 중이 아닌 로컬 모델은 목록과 선택된 항목에 실행 중이 아님으로 표시됩니다.
- 클라우드 모델: OpenAI, Anthropic, Gemini 등 구성된 클라우드 프로바이더의 모델 (프로바이더 이름 표시)
필요할 때 모델 실행
여기서 고른 로컬 모델은 해당 모델을 사용하는 기능이 필요로 할 때 실행됩니다. 에이전트 기본 모델은 에이전트나 스쿼드 실행이 시작될 때, 추출 모델과 제목 생성 모델은 메모리나 제목을 쓸 때, 위키 생성 모델과 데이터 요약 모델은 작성을 시작할 때, 유틸리티 모델은 요약을 쓸 때 실행되고, 모델이 준비되는 동안 알림에 모델 이름이 표시됩니다. 따로 켤 설정은 없으며, 예전의 필요 시 자동 실행 스위치는 없어졌습니다.
모델은 이미 실행 중인 모델과 함께 메모리에 들어갈 때만 실행됩니다. 메모리가 부족하거나, 모델 라이브러리에 더는 없거나, 실행에 실패하면 다른 모델로 대신하지 않고 작업이 멈추는데, 이때 알림에 이유가 표시되고 메모리가 부족한 경우에는 필요한 메모리와 여유 메모리도 함께 표시됩니다. 없음으로 둔 설정은 위에서 설명한 대체 동작을 그대로 따릅니다.
시작할 때 실행되는 모델
설정 > 일반 > 시작 모델 정책은 앱을 시작할 때 채팅이 어떤 모델로 시작할지 정하는 설정입니다. 설정 마법사에서 첫 모델을 고르면 시작 모델 선택 단계에서도 같은 질문을 합니다. 이 질문이 생기기 전에 설정을 마쳤다면, 마지막에 사용한 모델이 앱 시작과 함께 처음 실행될 때 알림 센터에 알림이 한 번 표시되고 바꿀 수 있는 곳도 함께 안내합니다.
- 마지막에 사용한 모델로 시작(기본값): 마지막에 대화한 모델이 앱을 시작할 때 실행됩니다.
- 고정한 모델로 시작: 지난번에 어떤 모델을 골랐든 앱을 시작할 때마다 같은 모델로 채팅이 시작됩니다. 정책 아래의 시작 모델에서 모델을 고르면 되고, 로컬 모델은 앱이 시작될 때 실행되며 클라우드 모델은 선택만 됩니다. 모델 페이지에서 모델 카드의 ⋯ 메뉴에 있는 시작 모델로 고정으로도 로컬 모델과 클라우드 모델을 고정할 수 있고, 같은 메뉴의 시작 모델 고정 해제를 누르면 정책이 마지막에 사용한 모델로 돌아갑니다.
- 필요할 때 실행: 앱을 시작할 때 실행되는 모델이 없습니다. 마지막에 대화한 모델은 실행 중이 아님 상태로 선택된 채 남아 있고, 메시지를 보내면 실행됩니다.
클라우드 모델은 앱을 시작할 때 실행되지 않고 선택만 됩니다. 모델 카드에서 시작 시 자동 실행을 켜 둔 모델은 어떤 정책을 골랐든 앱을 시작할 때마다 채팅 모델과 함께 실행되고, 두 조건에 모두 해당하는 모델은 한 번만 실행됩니다. 예전의 명시적 플래그 사용 정책으로 저장된 설정은 필요할 때 실행으로 읽히며, 같은 모델들이 실행됩니다.
이전에 고른 모델이 없으면 이미 실행 중인 로컬 모델로 채팅이 시작됩니다. 실행 중인 모델도 없으면 모델 선택 창은 비어 있고 입력창에서 모델을 골라 달라고 안내하며, 클라우드 모델이 대신 선택되는 일은 없습니다.
디퓨전 모델 설정
모델 페이지에서 디퓨전(이미지 생성) 모델을 선택하고 설정을 열면 stable-diffusion.cpp(sd-server) 백엔드에 특화된 디퓨전 설정 드로어가 표시됩니다. 설정은 다섯 개의 탭으로 구성되어 있습니다.
개요 탭
선택한 모델에 대한 읽기 전용 정보를 표시합니다:
- 모델 이름, 파일 크기, 포맷, 아키텍처
- 디퓨전 타입 (SD 1.x, SD 2.x, SDXL, Flux 등)
- 퍼블리셔 및 리포지토리
- 파일 경로 (복사 버튼 포함)
구성 요소 탭
메인 디퓨전 모델과 함께 사용되는 보조 모델 파일을 구성합니다. 일부 필드는 모델 아키텍처에 따라 표시됩니다:
- VAE 모델: 고품질 디코딩을 위한 사용자 지정 Variational Autoencoder
- CLIP-L 인코더: SDXL 및 Flux 모델용 텍스트 인코더
- CLIP-G 인코더: SDXL 모델 전용 추가 텍스트 인코더
- T5-XXL 인코더: Flux 모델 전용 텍스트 인코더
- LLM 인코더: Qwen-Image 모델 전용 텍스트 인코더
- 디퓨전 모델: Qwen-Image 모델 전용 독립 디퓨전 가중치
- TAESD: 빠른(저품질) 미리보기 디코딩을 위한 초소형 오토인코더
- ControlNet: 가이드 이미지 생성을 위한 모델
- LoRA 디렉토리: LoRA 어댑터 파일이 포함된 디렉토리
- 임베딩 디렉토리: 텍스트 인버전 임베딩 파일이 포함된 디렉토리
- 업스케일 모델: 이미지 업스케일링을 위한 ESRGAN 모델
생성 설정 탭
이미지 생성 요청의 기본값을 설정합니다:
- 너비 / 높이: 기본 이미지 크기 및 프리셋 버튼 (SD 1.x, SD 2.x, SDXL, Portrait, Landscape)
- 스텝: 디노이징 스텝 수 (1--150). 스텝이 많을수록 품질은 높아지지만 느려집니다.
- CFG 스케일: Classifier-Free Guidance 스케일 (0--30). 텍스트 프롬프트에 대한 이미지의 충실도를 제어합니다.
- 가이던스: Flux 모델용 가이던스 값 (0--10)
- 샘플링 방법: 디노이징 알고리즘 (euler, euler_a, dpm++2m 등)
- 스케줄러: 노이즈 스케줄 타입 (discrete, karras, exponential 등)
- CLIP 스킵: 건너뛸 CLIP 레이어 수 (-1 = 없음, 최대 12)
- 시드: 재현성을 위한 랜덤 시드 (-1 = 무작위)
- 배치 카운트: 한 번에 생성할 이미지 수 (1--8)
- 네거티브 프롬프트: 피해야 할 내용을 설명하는 기본 텍스트
- 강도: img2img 디노이징 강도 (0.0--1.0)
하드웨어 탭
추론 서버의 하드웨어 활용을 구성합니다:
- 스레드: 사용할 CPU 스레드 수 (-1 = 자동, 또는 1--64)
- Flash Attention: 메모리 효율적 어텐션 활성화
- 디퓨전 Flash Attention: 디퓨전 레이어에만 적용되는 Flash Attention
- VAE 타일링: VRAM 사용량을 줄이기 위해 VAE를 타일 단위로 처리
- VAE 타일 크기 / 오버랩: 타일 크기와 겹침 비율
- CPU 오프로드 옵션: 모델, CLIP, 또는 VAE를 CPU로 오프로드
- 메모리 매핑 (mmap): 메모리 매핑 파일 접근 사용
- 가중치 타입: 모델 가중치 정밀도 재정의 (f32, f16, q4_0 등)
고급 탭
특수 매개변수를 세밀하게 조정합니다:
- RNG 타입: 난수 생성기 백엔드 (std_default, cuda, cpu)
- Flow Shift: Flux/SD3 플로우 기반 모델의 시프트 값
- LoRA 적용 모드: LoRA 가중치 적용 시점 (auto, immediately, at_runtime)
- SLG 매개변수: Skip Layer Guidance 스케일, 시작 및 종료 지점
- 순환 패딩: 타일링 가능한 텍스처를 위한 원활한 타일링 활성화
- 예측 타입: 노이즈 예측 방법 (eps, v, edmv, sd3flow, fluxflow, sefiflow, minit2i_flow)
- Qwen zero cond T: Qwen-Image 모델에서
zero_cond_t활성화
설정 변경 시 재시작 필요
구성 요소, 하드웨어 및 고급 탭의 값은 추론 서버의 실행 인자이므로, 모델을 중지하고 다시 실행해야 적용됩니다. 저장된 설정은 모델을 실행할 때마다 읽어들이며, 캔버스 페이지나 에이전트 도구가 자동으로 실행한 경우에도 동일하게 적용됩니다. 생성 설정 탭의 값은 요청마다 적용되므로 재시작이 필요 없습니다.